Outsourcing de desarrollo back-end con bandas en USD desde Argentina
· Primer endpoint nuevo en staging: típicamente 12 a 22 días hábiles post kickoff
Ofrecemos outsourcing de desarrollo back-end para equipos de producto y SaaS que necesitan APIs confiables, integraciones con terceros y plataformas observables, no solo más tickets cerrados. Trabajamos desde Córdoba (GMT-3) con traslape usable a EE. UU., integrándonos a tu repositorio, CI y ceremonias.
Si llegaste por búsqueda, probablemente comparás contratar desarrolladores back-end sueltos, un squad back-end dedicado o un slice de desarrollo por proyecto. En esta página verás qué entregamos, la puerta de confiabilidad de plataforma que usamos antes de staffear, bandas en USD alineadas a desarrollo nearshore, riesgos típicos y FAQs. Para servicios solo de superficie HTTP, mirá desarrollo de APIs; para eventos y Kubernetes, desarrollo de microservicios.

Qué entregamos en outsourcing back-end (y qué no)
Nos hacemos cargo de servicios, datos en movimiento, colas, jobs programados, integraciones OAuth y webhooks, migraciones de esquema con rollback, y la observabilidad que permite operar todo eso. No reemplazamos tu product management ni vendemos un stack paralelo: el código vive en tu org.
Cuando ventas o finanzas necesitan datos de Salesforce, Stripe o ERP sin scripts frágiles, encajan nuestros servicios de integración de APIs. Para paneles admin y flujos de aprobación, desarrollo de herramientas internas. Para marts y frescura de datos, desarrollo de pipelines de datos. Si el cuello de botella es la plataforma de entrega (IDP, caminos dorados), coordinamos con ingeniería de plataformas.
Para quién contratan outsourcing back-end
SaaS con APIs que no aguantan el próximo pico
Necesitás caching, colas y presupuesto de error antes de que marketing dispare tráfico.
Fintech o healthtech con compliance
Audit trail, rotación de secrets y controles de acceso son requisito, no nice-to-have.
Monolito que frena releases
Buscás extracción gradual con contract tests, no un rewrite de seis meses sin entregas.
Datos fragmentados entre ERP y producto
Unificás feeds con gobernanza y linaje, no con otro script cron en un servidor olvidado.
Puerta de confiabilidad de plataforma (tres señales)
Antes de proponer composición del equipo, puntuamos tres sí/no con tu tech lead o EM:
- SLOs o presupuesto de error definidos para las APIs o jobs que vamos a tocar (aunque sea un documento corto).
- Owner de contrato (OpenAPI, esquema de eventos o ADR) por cada bounded context que modificamos.
- Camino de deploy reversible (feature flags, blue/green o canary) sin ventana de cambio obligatoria de 48 horas.
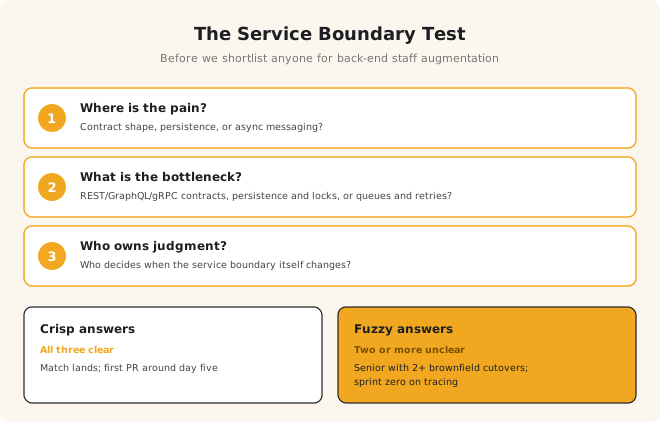
Dos respuestas afirmativas suelen indicar staff augmentation o squad chico. Cero afirmativas implican sprint de discovery (5 a 7 días hábiles) antes de tocar producción. Referencia operativa: prácticas de presupuesto de error en el marco de SLOs de Google SRE y guías de contratos en OpenAPI Initiative.
Cómo trabajamos del kickoff a operación estable
Semana 1: accesos, mapa de datos y taller de confiabilidad. Semana 2: contract tests o gates de migración en CI. Semana 3: primer incremento en staging con trazas y alertas mínimas. Semana 4: revisión honesta de velocidad, deuda abierta y si hace falta QA o SRE adicional.

Modelos, bandas en USD y qué mueve el número
Staff augmentation
USD 6.500 a 12.500/mes por senior todo incluido (rangos publicados en desarrollo nearshore).
Squad back-end dedicado
USD 22.000 a 48.000/mes (detalle en equipo back-end dedicado).
Proyecto cerrado
USD 25.000 a 180.000 totales típicos según alcance y compliance (misma referencia nearshore).
Stacks de nicho (Rust de sistemas, compliance pesado, multi-región) pueden mover la cotización. Lo confirmamos por escrito tras el brief.
Outsourcing vs freelancers vs contratación interna
Freelancers resuelven tareas puntuales; contratación interna resuelve ownership a largo plazo pero tarda en ramp up. Outsourcing back-end con Siblings apunta al medio: continuidad de guardia, bench para reemplazos, traslape GMT-3 con US Eastern, y entrega que incluye observabilidad y runbooks, no solo pull requests.
Coordinamos ceremonias con tu desarrollo front-end cuando contratos de API y UI comparten release train.
Stack, vetting y decisiones de persistencia
Lenguajes frecuentes: Java con Spring Boot, Node.js, Python FastAPI, Go, .NET, y Rust cuando latencia y seguridad de memoria importan. Datos: PostgreSQL (comunidad PostgreSQL), Redis, Kafka, warehouses cloud. Infra: Kubernetes y Terraform alineados a lo que tu equipo ya opera; trazas con OpenTelemetry.
El vetting incluye pairing en migración de esquema o consumidor de cola parecido a tu backlog, revisión de manejo de idempotencia y preguntas explícitas sobre ownership de on-call post handoff.
Prueba social verificable (sin métricas inventadas)
En lugar de mini casos anónimos con porcentajes no auditados, enlazamos trabajos documentados: colaboración segura y operación en HighSide; plataforma B2B en Bari; operaciones de pagos en Viking; contribución Go en NetApp. Más relatos en casos de éxito.
Riesgos que planificamos antes de firmar
- Base de datos compartida entre servicios sin owner de esquema: congelamos features hasta definir migraciones y rollback.
- Integraciones sin idempotencia: diseñamos colas, DLQ y replays antes de conectar partners de producción.
- Guardia huérfana: acordamos quién recibe alertas y runbooks antes del go-live, no el viernes del cutover.
NUESTROS ESTÁNDARES
Observabilidad y seguridad versionadas con el código. Threat modeling en features que mueven dinero o datos sensibles. Documentación para que tu equipo interno opere después del handoff.
Preguntas Frecuentes
Entrega gestionada de lo que vive detrás del producto: diseño y evolución de APIs, modelos de datos, colas y jobs, integraciones con terceros, pipelines de despliegue, observabilidad y runbooks. Los ingenieros entran a tus repos y ceremonias, no a un carril paralelo. Cuando el trabajo es solo la superficie HTTP, muchos equipos combinan esta página con desarrollo de APIs o microservicios; cuando el gap es personas embebidas, miran staff augmentation back-end.
Los freelancers optimizan tickets cerrados. Nosotros optimizamos continuidad operativa: tech lead que posee contratos de API, QA que entiende regresiones de datos, plan de rampa escrito y handover de dos ingenieros cuando alguien rota. El vetting termina en tu repositorio con un cambio acotado y pairing en un incidente parecido al tuyo, no con un test genérico en una plataforma.
Staff augmentation encaja cuando ya tenés tech lead, SLOs y quien aprueba migraciones: sumás uno o dos seniors en una o dos semanas. Un squad dedicado encaja cuando necesitás ownership de un dominio completo con QA y entrega coordinada, típico en modernización o lanzamientos multi-servicio. Proyecto cerrado encaja cuando el slice está acotado (nueva integración, extracción de un módulo, hardening de observabilidad) con acceptance tests firmados antes del kickoff.
Usamos los mismos rangos publicados en desarrollo nearshore y en el squad back-end dedicado: ingeniero senior todo incluido entre USD 6.500 y USD 12.500 por mes; squad de 4 a 8 personas con tech lead, QA y PM entre USD 22.000 y USD 48.000 por mes; proyectos cerrados con alcance acordado suelen caer entre USD 25.000 y USD 180.000 totales según duración y compliance. La cotización escrita llega en menos de cinco días hábiles tras un brief con stack y restricciones.
Arrancamos con inventario de dependencias, contract tests alrededor de endpoints existentes y routing gradual (strangler) detrás de feature flags. Replicación de datos y despliegues blue/green permiten mover tráfico por slices. Dejamos scripts de rollback y dashboards alineados a tus SLOs. Para programas grandes de extracción de monolito, muchos compradores combinan este servicio con modernización de aplicaciones o microservicios según el mapa de contextos.
Sí, es el default. Entramos por SSO o VPN, respetamos branch protection, secrets manager y checklists de onboarding que ya uses para SOC 2 o HIPAA. Si el pipeline aún es frágil, el sprint cero co-crea gates de migración de esquema, plantillas de ADR y política de dependencias. OpenTelemetry y alertas se versionan junto al código que instrumentamos.
Después de la rampa inicial, cualquier parte puede avisar con 15 días de anticipación. Entregamos pack de handover: diagramas de flujo de datos actualizados, lista de deuda técnica abierta, runbooks de guardia y pull requests reducidos a unidades mergeables. La documentación queda en tu wiki o repositorio, no en un drive nuestro.
Servicios relacionados
Modernización de aplicaciones · Ingeniería DevOps · Hub de outsourcing
Versión en inglés: página back-end en inglés.