Carreras
Trabajo remoto en software con proyectos que tienen usuarios reales
Siblings Software es una empresa de outsourcing de software con base en Estados Unidos y hub de ingeniería en Córdoba, Argentina, con squads trabajando remote-first en Latinoamérica desde 2018. Buscamos ingenieros senior, especialistas en IA y cloud, ingenieros de QA y release, y líderes de delivery para proyectos de largo plazo con clientes de Estados Unidos, Canadá y Europa en fintech, salud, eCommerce, logística y SaaS.
Esta es una página de carreras de verdad, no un pitch de recruiter. Si sos developer y querés escribir pull requests revisados en sprints de dos semanas, estar en un squad chico con pares senior y ser dueño/a de código de producto que llega a usuarios que pagan, hay un buen fit. Si buscás una organización de plataforma de 200 personas, comida gratis o un ranking interno, este no es el lugar.
Ver posiciones abiertas Cómo aplicar
Escrito y revisado por Javier Uanini, fundador y CEO de Siblings Software, con aportes del equipo de recruiting.
Los números, sin maquillaje
La mayoría de las páginas de carreras esquiva los números reales de operación. Acá están los nuestros, con las aclaraciones que corresponden.
10
POSICIONES ABIERTAS HOY
Roles remotos como contractor en Argentina, Brasil, Colombia, México y el resto de la región.
2018
REMOTE-FIRST DESDE
Hub de ingeniería en Córdoba, con clientes en Estados Unidos, Canadá y Europa en fintech, salud, eCommerce, logística y SaaS B2B.
3–8
INGENIEROS POR SQUAD
Contando a los ingenieros del cliente. Lo bastante chico para que la daily entre en quince minutos.
2–24+
MESES POR PROYECTO
Hay engagements de duración fija de dos a cinco meses y squads que llevan años con el mismo cliente. Cada posición dice cuál es el caso.
6–8 h
OVERLAP TÍPICO CON EST
Desde México, Colombia, Perú y casi toda Centroamérica. En Argentina, Uruguay y Chile el día local se corre un par de horas.
1–2 sem
DEL CV A LA OFERTA
Revisión de CV en tres a cinco días hábiles, después una o dos entrevistas. Te decimos cuál es la ronda que define.
Son rangos operativos que salen de cómo funciona la empresa, no estadísticas auditadas. Los dos primeros son datos públicos de Siblings Software. El resto es lo típico de proyectos recientes y puede cambiar en un rol puntual; en la entrevista te damos el número que aplica a tu caso.
Foto de búsquedas — para qué estamos contratando a fines de 2026
La mezcla cambia con el roadmap de los clientes. Esto es lo que se ve hoy en una semana real de screening.
MEZCLA DE POSICIONES, OCTUBRE 2026
Qué está buscando recruiting este trimestre
- Cloud, seguridad e infraestructura ~30%. Ingeniería de seguridad en GCP, optimización de costos en AWS (FinOps) y un rol de lead de infraestructura entre data centers propios y nube pública. Terraform, Kubernetes e IAM son la base; evaluamos ownership en producción, no solo certificados.
- IA y sistemas agénticos ~20%. Trabajo en producción con LLMs, RAG y agentes en Python, desde automatizar flujos con mucha documentación hasta consultoría de IA agéntica en Vertex AI con LangGraph, ADK y MCP.
- QA y release mobile ~20%. Quality engineering mobile senior con Espresso y XCUITest, y release engineering para apps nativas de iOS y Android con feature flags y CI/CD.
- Delivery y análisis de negocio ~20%. Un project manager con buen manejo de Scrum y un business analyst de Salesforce, los dos en engagements de duración fija.
- Backend y sistemas distribuidos ~10%. Servicios en Rust sobre almacenamiento distribuido, con gRPC, service mesh y trade-offs reales de replicación y consistencia.
Los porcentajes son la proporción de las diez posiciones abiertas hoy. La mezcla es irregular: un squad dedicado nuevo puede mover una fila 10 a 15 puntos en un mes.
QUÉ EVALUAMOS EN 2026
Las señales que llevan un CV de la revisión a la entrevista
- Historial real de code review. Un repo público donde hayas dejado review no trivial en el pull request de otra persona — no solo mergear los tuyos — pesa más que otra certificación.
- Una decisión tuya que defenderías por escrito. Un ADR, un postmortem que escribiste, una design note que eligió entre dos opciones. Te vamos a preguntar por eso en la primera entrevista.
- Criterio con herramientas de IA, no volumen. Asumimos que Cursor, Claude Code o Copilot están en tu flujo. Lo que evaluamos es si rechazás el diff de un modelo cuando el trade-off está mal, y si escribís el test que lo demuestra.
- Experiencia de on-call en producción. Si te despertaron a las 3 de la mañana por un sistema que escribiste, entendés la observabilidad de otra forma. Eso vale más que un certificado de Kubernetes.
- Un stack principal claro. Contratamos generalistas, pero necesitamos saber en qué proyecto ubicarte el trimestre que viene, así que un stack principal claro ayuda.
Los CVs que parecen una lista de todos los frameworks que tocaste reciben un no amable. Los CVs con dos stacks y una historia detrás de cada uno llegan a la entrevista.
Si tu stack no aparece en la mezcla de este trimestre y igual querés hablar con nosotros, mandá el CV. Mantenemos un pequeño banco de candidatos para proyectos que se cierran en dos semanas, y un senior en un stack poco representado es justo el perfil que más pide la próxima llamada comercial.
Cómo es trabajar acá de verdad
Honestos con la cadencia, las zonas horarias y los trade-offs — antes de que gastes una hora de entrevista.
La mayor parte de lo que hacemos es delivery por proyecto: un squad chico — en general de tres a ocho ingenieros contando los del cliente — trabajando en un producto durante algunos meses o varios años. Vas a estar en el Slack del cliente, en sus reviews de PR y en su Jira. Lo que te llega el lunes a la mañana es lo que sale a sus usuarios.
Squads chicos, sprints de dos semanas
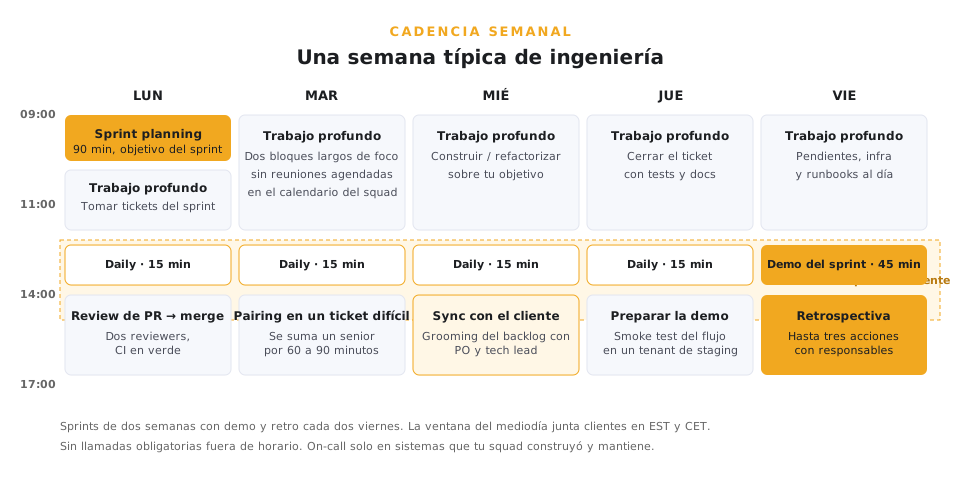
Trabajamos en sprints de dos semanas con un objetivo real, dailies de quince minutos, una demo los viernes y una retro que cierra sus acciones. Los story points quedan dentro del squad; la métrica que miramos es si se cumplió el objetivo del sprint.
La realidad de las zonas horarias
La mayoría de nuestros clientes trabaja en horario del Este de Estados Unidos, y algunos en Reino Unido y Europa occidental. Desde Argentina, Colombia, México y casi toda Latinoamérica eso coincide con tu jornada normal. Algunos roles piden otra ventana, como horario del Pacífico, y lo dicen en la publicación. A algunas personas les sirve y a otras no — preguntalo en la entrevista.
Autonomía y ownership
Vas a ser dueño/a de features de punta a punta — desde la design note, pasando por el review y staging, hasta producción. Los tech leads tienen veto sobre la complejidad prematura, pero no hacen micromanagement. Se espera que tomes tus propias decisiones técnicas y que escribas los trade-offs cuando importan.
Variedad de proyectos, con profundidad
Hay ingenieros que se quedan años en un mismo proyecto y otros que rotan cuando un proyecto termina. Esa mezcla hace que un senior que entró hace dos años probablemente haya trabajado en dos o tres stacks distintos — React Native un trimestre, servicios en Go el siguiente.
El chequeo de fit en tres preguntas
Un marco corto y con opinión que les pedimos a los candidatos que se apliquen antes de la primera entrevista. Le ahorra una hora a las dos partes.
La respuesta honesta a estas tres preguntas nos dice, a nosotros y a vos, si un puesto en Siblings va a ser el mejor año de tu carrera o un mal fit para el cuarto mes. Lo venimos usando de manera informal con cada contratación senior desde 2022. Ninguna es excluyente por sí sola; si dos de tres apuntan para el otro lado, normalmente sí lo es.
PREGUNTA 1
¿Un día laboral de Estados Unidos es un día normal para vos?
Desde México, Colombia, Perú y casi toda Centroamérica la respuesta es sí por defecto. Desde Argentina, Uruguay y Chile vas a trabajar más o menos de 11 a 19 hora local. Desde Brasil depende de la ciudad. Si el horario te va a molestar para el segundo mes, es un no rotundo y preferimos saberlo ahora.
PREGUNTA 2
¿Querés tomar la decisión, no solo implementarla?
Los squads son chicos. De un semi senior o senior se espera que escriba la design note, que muestre los trade-offs en el review y que no esté de acuerdo con el tech lead por escrito cuando cree que la decisión está mal. Si preferís que te den un ticket de Jira con criterios de aceptación, desde la primera semana va a ser incómodo.
PREGUNTA 3
¿Podés quedarte en un producto un año o más?
Muchos de nuestros proyectos duran entre seis y veinticuatro meses, y varios más. Vas a conocer el código, las alertas de on-call, al head of product y las decisiones legacy que te gustaría que alguien hubiera documentado. Los ingenieros que necesitan un stack nuevo cada trimestre se queman acá. Los que disfrutan terminar cosas se quedan.
Te vamos a hacer versiones de las tres en la entrevista. Las respuestas honestas, incluso los "no", suman más que las actuadas. Contratamos ingenieros que dijeron que no a la tercera y fueron el fit justo para un proyecto de seis meses; y no avanzamos con gente que dijo que sí a las tres pero no pudo nombrar una decisión real que haya tomado en su último rol.
Posiciones abiertas
Estas son las posiciones abiertas hoy, actualizadas el 20 de octubre de 2026. Todas son engagements remotos como contractor en Latinoamérica: Argentina, Brasil, Colombia, México y, en algunos roles, el resto de la región. Cada publicación indica el país, el nivel de inglés y la duración. Si no ves tu rol exacto, mandá el CV igual — mantenemos un pequeño banco de candidatos para los proyectos que se cierran la semana siguiente.
Project Manager (Brasil)
Ubicación: Brasil, remoto · Inglés: C1 · Duración: 5 meses, contractor
Liderar la entrega de punta a punta de una plataforma de comercio digital construida sobre una arquitectura moderna y componible. El trabajo combina desarrollo de producto nuevo con consultoría de transformación digital: vas a ser delivery lead y Scrum Master de un equipo multifuncional y multinacional.
Responsabilidades
- Cumplir el alcance, los plazos, la calidad y los objetivos de negocio acordados
- Gestionar alcance, riesgos, issues, dependencias, supuestos y pedidos de cambio en todo el SDLC con un marco claro de gestión de riesgos
- Coordinar Producto, Tecnología, QA, Arquitectura y stakeholders de negocio de distintos países
- Facilitar las ceremonias de Scrum: sprint planning, dailies, sprint reviews y retrospectivas
- Seguir el avance y la capacidad del equipo, y preparar reportes de estado RAG periódicos
- Administrar el proyecto en Jira: tableros, sprints, releases, workflows y planificación de capacidad
- Llevar releases y salidas a producción, incluyendo planes de cutover, hypercare y el pase a operación
Requisitos
- Experiencia comprobable liderando equipos multifuncionales y multinacionales (excluyente)
- Experiencia práctica con Scrum; capacidad de actuar como Scrum Master
- Manejo avanzado de Jira (administración y reportes)
- Gestión de presupuesto y costos, gestión del cambio y muy buena comunicación con stakeholders
- Inglés oral y escrito sólido (C1)
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
Salesforce Business Analyst
Ubicación: Argentina o Brasil, remoto · Inglés: B2+ · Duración: 2,5 meses con posible extensión, contractor
Impulsar la reestructuración de permisos de una org de Salesforce empresarial. Vas a ser el puente entre los usuarios finales y el equipo core de Salesforce: hacer discovery, mapear user personas y escribir las user stories que definen un modelo de accesos seguro y escalable.
Responsabilidades
- Hacer entrevistas, workshops y sesiones de shadowing con las áreas de negocio para entender su operación diaria y sus necesidades de acceso a datos
- Traducir procesos de negocio en user stories claras con criterios de aceptación sólidos
- Documentar los flujos actuales y futuros para detectar brechas y redundancias de acceso
- Trabajar con el equipo de producto y administración de Salesforce para convertir necesidades en requisitos de permisos
- Participar en sesiones de grooming para que los requisitos estén claros antes de desarrollar
- Coordinar usuarios para UAT y validar que los permisos entregados coincidan con lo documentado
Requisitos
- 5+ años como Business Analyst de Salesforce
- Muy buen manejo de objetos y campos de Salesforce, y conocimiento práctico de Profiles, Permission Sets y Permission Set Groups (tenés que poder armar un permission set)
- Experiencia con Salesforce Sales Cloud
- Experiencia relevando requisitos con stakeholders no técnicos y escribiendo user stories ágiles de calidad
- Excelente comunicación y el hábito de hacer la pregunta incómoda
- Capacidad de convertir descripciones operativas desordenadas en requisitos estructurados
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
GCP Security – Cloud Engineer
Ubicación: remoto desde Argentina, Brasil, Chile, Colombia, Costa Rica, República Dominicana, Ecuador, El Salvador, Guatemala, Honduras, México, Panamá, Paraguay, Perú o Uruguay · Inglés: B2+ · Español: C1+ · Duración: 3 meses con posible extensión, contractor
Ingeniero/a senior de seguridad cloud que diseña e implementa políticas, guardrails y bases de seguridad en Google Cloud Platform, trabajando con CISOs y equipos de seguridad en un contexto de consultoría.
Requisitos
- 6+ años diseñando e implementando políticas y servicios seguros, preferentemente en GCP
- Análisis y mitigación de amenazas con herramientas SIEM como Google SecOps (ex Chronicle), Wiz o similares
- Experiencia definiendo estrategia y gobierno de seguridad junto a CISOs e ingenieros de seguridad
- Aplicación de controles regulatorios y soporte a equipos de SOC o SecOps en cumplimiento
- IAM avanzado: jerarquías de recursos, protección de perímetros, comunicaciones seguras y Workload Identity Federation
- Seguridad de red en GCP: Cloud Firewall, Cloud Armor, diseño de VPC, protección de datos y Security Command Center
- Landing zones seguras y bases de datos e IA, incluyendo perímetros para tráfico usuario-agente, agente-agente y agente-servicio
- Uso de agentes de IA para automatizar y reducir el riesgo de tareas de seguridad e infraestructura
- Infraestructura como código (Terraform) para bases de seguridad orientadas a cumplimiento, buenas prácticas de seguridad en GKE y pipelines de CI/CD y DevSecOps seguros
- Experiencia en servicios profesionales o consultoría técnica, con buena comunicación y capacidad de negociación
Deseable
- Certificación Google Professional Cloud Security Engineer, Professional Cloud Architect o Professional Security Operations Engineer
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
AWS Cost Optimization Engineer
Ubicación: Colombia o México, remoto · Inglés: B2+ · Modalidad: contractor
Darles a los equipos de ingeniería visibilidad sobre el gasto cloud y bajarlo con un enfoque basado en datos para alertas, reportes y optimización en un entorno AWS grande. Venís de DevOps o SRE y te gusta convertir datos de facturación en decisiones.
Responsabilidades
- Trabajar con los equipos de ingeniería para encontrar oportunidades de ahorro y hacer eficiente la infraestructura cloud
- Entender cómo está armado y desplegado el producto, y cuánto cuesta cada parte del entorno
- Asesorar a arquitectos e ingenieros en optimización de recursos, reducción de desperdicio, gestión de capacidad y KPIs
- Detectar aumentos de costo y anomalías de uso, y rastrear su origen
- Recomendar y seguir compras de compromiso: Reserved Instances, Savings Plans y Spot
- Construir y mantener reportes, dashboards, alertas y forecasts de costo y uso
- Ayudar a crear, automatizar y gobernar políticas de optimización, y reportar ahorros contra KPIs
Requisitos
- Experiencia práctica en DevOps o SRE
- Conocimiento profundo de infraestructura AWS, reportes de costos y optimización a escala
- Experiencia con AWS EKS y contenedores
- AWS Cost Explorer, Cost and Usage Report, AWS Budgets y CloudHealth o similares
- Experiencia armando dashboards, modelos y reportes de costos para equipos de ingeniería
- Detallista, cómodo/a trabajando de forma autónoma y en varios proyectos a la vez
- Comunicación oral y escrita clara para públicos técnicos y no técnicos
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
Software Engineer – Backend / Sistemas Distribuidos (Rust)
Ubicación: Argentina, Brasil, Colombia o México, remoto · Inglés: B2+ · Modalidad: contractor
Diseñar, construir y operar servicios backend de alto rendimiento que corren sobre sistemas de almacenamiento distribuido, y compartir el on-call de esos servicios. Es trabajo de sistemas: concurrencia, RPC, replicación y consistencia, no un CRUD sobre una base de datos administrada.
Responsabilidades
- Diseñar, desarrollar y mantener servicios backend escalables y confiables que interactúan con varios sistemas de almacenamiento
- Dar soporte on-call, resolver problemas en producción y depurar fallas complejas
- Colaborar con equipos distribuidos globalmente, con alguna reunión temprana o tarde para coincidir con la costa oeste de EE. UU. y Asia-Pacífico
Requisitos
- Rust sólido y experiencia comprobable en desarrollo backend
- Conocimiento práctico de Go, Java y Python, y capacidad de entregar features no triviales en un framework nuevo en pocos días
- Suficiente C/C++ para leer y razonar sobre sistemas complejos escritos en esos lenguajes
- Muy buena base de estructuras de datos y algoritmos, y experiencia diseñando sistemas distribuidos escalables y de alta disponibilidad
- Programación concurrente: async, multi-threading y modelos de concurrencia
- Servicios RPC con gRPC o Apache Thrift (REST solo no alcanza)
- Entornos cloud-native: service discovery (Consul, ZooKeeper), service mesh (Envoy, Istio) y redes IPv6
- Conceptos de almacenamiento distribuido que hayas construido u operado: modelos de consistencia, particionado y resharding, replicación y tolerancia a fallas
Cada requisito tiene que estar respaldado por experiencia real en proyectos. Preparate para explicar, con ejemplos, cómo un dato escrito en un nodo se vuelve visible en otro.
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
Senior Quality Engineer (Mobile)
Ubicación: Argentina, remoto · Inglés: B2 · Modalidad: contractor
Ser responsable de la calidad de apps nativas de iOS y Android: estrategia de testing, pruebas funcionales y automatizadas, y los frameworks de automatización de UI que mantienen la cobertura de regresión cerca del 100 por ciento.
Responsabilidades
- Trabajar con Producto, Diseño y Desarrollo para convertir requisitos en planes y casos de prueba
- Ejecutar pruebas funcionales y automatizadas, e integrar las suites automatizadas al CI
- Extender los frameworks de automatización de UI sobre Espresso (Android) y XCUITest (iOS)
- Revisar y enviar pull requests hacia la automatización completa de la regresión
- Encontrar, documentar y seguir defectos hasta su corrección y re-test
- Adelantar el testing junto a los developers con estrategias de mocking, y mejorar el proceso y las buenas prácticas de QA
Requisitos
- 7+ años de experiencia técnica y título en Ciencias de la Computación, Ingeniería o afines
- Experiencia práctica testeando en iOS y Android
- 3+ años de automatización mobile con herramientas como Appium, Katalon o similares
- Testing funcional, de integración, regresión, exploratorio, end-to-end, compatibilidad, APIs y accesibilidad
- Buen entendimiento de Swift o Kotlin, y sólidas habilidades de programación y debugging
- Testing de APIs con Postman, IntelliJ HTTP Client o similares
- Herramientas de debugging como Charles Proxy, Splunk y Sentry
- Experiencia en entornos ágiles y muy buena comunicación
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
Lead Infrastructure Engineer
Ubicación: México, remoto, en horario del Pacífico o del Este de EE. UU. con guardias on-call · Inglés: B2+ · Modalidad: contractor
Diseñar, automatizar y operar infraestructura en data centers propios y en nube pública (GCP y AWS). El rol es para alguien que se formó en operaciones (racks, redes, instalaciones bare metal) y hoy marca la dirección técnica, mentorea ingenieros y lidera la migración a infraestructura como código moderna.
Responsabilidades
- Diseñar y operar infraestructura multi data center que combina hardware on-prem, GCP y AWS
- Liderar la automatización de despliegue y configuración, migrando herramientas legacy a Terraform, Puppet y Ansible
- Diseñar y mantener gestión de tráfico, balanceo de carga y DNS a escala
- Construir monitoreo y observabilidad on-prem y en la nube
- Desarrollar herramientas para administración de sistemas distribuida y auditable, y documentar procesos y políticas
Requisitos
- 10+ años en ingeniería de infraestructura o sistemas con responsabilidad directa sobre producción
- Gestión remota de hardware físico en centros de colocation
- Administración Linux avanzada (Red Hat, Debian o similares) a escala
- Redes: hardware Cisco, DNS, balanceo de carga y gestión de tráfico
- Sistemas de almacenamiento y backup empresariales
- Automatización con Ansible, Puppet o similares, y Python (o similar) para herramientas
- GCP en producción: Compute Engine, redes, storage e IAM
- Experiencia liderando proyectos de infraestructura y mentoreando ingenieros
Deseable
- Migraciones de cargas on-prem a nube pública
- Grafana, Prometheus u otros stacks de monitoreo y logging distribuidos
- Kubernetes y GKE
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
Experience & Technical Consultant (IA agéntica)
Ubicación: Argentina, Brasil o Colombia, remoto · Inglés: B2+ · Modalidad: contractor
Consultor/a hands-on que lidera el discovery técnico con clientes enterprise y después co-desarrolla soluciones de IA agéntica con sus equipos de ingeniería, desde la arquitectura de referencia y el MVP hasta producción en Google Cloud.
Responsabilidades
- Liderar sesiones de discovery técnico y traducir problemas de negocio en requisitos y arquitecturas robustas
- Co-desarrollar con los equipos del cliente: implementaciones y arquitecturas de referencia, y buenas prácticas
- Entregar de forma incremental, validando MVPs y llevándolos a nivel producción
- Negociar trade-offs técnicos con stakeholders técnicos y de negocio
- Moverte en entornos con políticas de seguridad estrictas y arquitecturas legacy
- Convertir fricciones recurrentes en módulos reutilizables
Requisitos
- 5+ años trabajando directamente con clientes enterprise
- Frameworks de orquestación de agentes como LangGraph, CrewAI o Google Agent Development Kit (ADK)
- Model Context Protocol (MCP), Agent-to-Agent (A2A), tool calling, ruteo dinámico y patrones de razonamiento (ReAct, autorreflexión, delegación jerárquica)
- RAG y búsqueda vectorial con Cloud SQL, AlloyDB, BigQuery o soluciones líderes del mercado
- Guardrails y seguridad semántica contra prompt injection, jailbreaks y fuga de datos, más validación de salidas y detección de alucinaciones
- LLMOps y observabilidad con Langfuse o AgentOps (métricas de latencia, costo y tokens)
- Ciclo de vida de ML completo en Vertex AI: pipelines, experimentos, model registry, feature stores, monitoreo y evaluación
- Python (excluyente), más Java, Go o C++
- BigQuery, Cloud Spanner, Bigtable, Firestore y ecosistemas SQL y NoSQL en general; pipelines de datos escalables
- Integración de IA vía REST, gRPC y SSE sobre GKE, Cloud Run y Apigee, con VPC Service Controls e IAM
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
Senior AI Engineer (Brasil)
Ubicación: Brasil, remoto · Inglés: B2 · Modalidad: contractor (nivel senior o lead)
Detectar oportunidades de alto impacto para la IA en flujos de negocio complejos y con mucha documentación, y después diseñar, construir y operar los sistemas de IA en producción que los automatizan. Trabajás directo con equipos de negocio y operaciones, y sos dueño/a del ciclo de producto desde el prototipo hasta el monitoreo.
Responsabilidades
- Construir aplicaciones de IA con LLMs, RAG, procesamiento de documentos, extracción de información, clasificación y arquitecturas basadas en agentes
- Ser dueño/a del ciclo completo: ideación, prototipo, despliegue, monitoreo y mejora continua
- Armar frameworks de evaluación: testing, monitoreo, performance y detección de alucinaciones
- Experimentar rápido y medir el impacto en tiempos de respuesta y productividad
- Mentorear ingenieros y promover buenas prácticas para sistemas de IA confiables
Requisitos
- 5 a 8+ años en ingeniería de software, IA o machine learning; título en Computación o Ingeniería, o experiencia equivalente
- Python sólido (excluyente); TypeScript y/o Node.js deseables
- Experiencia práctica con IA generativa y LLMs, RAG, comprensión de documentos y flujos agénticos
- Haber llevado productos de IA desde el concepto hasta producción
- Diseño de APIs, modelado de datos, diseño de sistemas, testing y desarrollo full-stack
- Cloud, Docker, CI/CD, autenticación y autorización, observabilidad y manejo seguro de datos
- Entender los trade-offs de la IA: costo, latencia, precisión, seguridad y riesgo de alucinación
- Capacidad de explicar conceptos técnicos a stakeholders de negocio
Deseable
- Experiencia en industrias reguladas y con mucha documentación
- Orquestación multi-agente, fine-tuning de LLMs y bases de datos vectoriales
- Kubernetes, infraestructura como código, arquitectura orientada a eventos, distributed tracing y feature flags
- Spark, Databricks o dbt; mentoría y liderazgo técnico
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
Release Engineer (Mobile)
Ubicación: Argentina, remoto · Inglés: B2 · Modalidad: contractor
Ser responsable del ciclo de release completo de apps nativas de iOS y Android y de los servicios backend que las soportan. El rol está entre Producto e Ingeniería y pide a alguien técnico, muy organizado y con muy buena comunicación.
Responsabilidades
- Gestionar el calendario de releases de iOS, Android y backend, y coordinar el alcance con Producto, Ingeniería, QA y Operaciones
- Conducir las revisiones de release readiness y las decisiones go/no-go
- Supervisar build, testing y despliegue, y coordinar las publicaciones en App Store y Google Play
- Mantener los despliegues de backend compatibles con las versiones mobile, y hacer cumplir las estrategias de versionado, tags y branches
- Ser dueño/a de los feature flags en producción: planificarlos, activarlos, desactivarlos, validarlos y monitorearlos
- Dar soporte en incidentes y rollbacks ligados a releases, monitorear la salud de cada release y mantener al día runbooks y checklists
Requisitos
- Release management de apps mobile nativas
- App Store y distribución de apps iOS
- CI/CD mobile con CircleCI y GitHub Actions
- Automatización de releases, gestión de feature flags y despliegues a producción
- Comunicar con seguridad el avance y los riesgos de cada release a los stakeholders
Postulate enviando tu CV a camila@siblingssoftware.com con el nombre del rol en el asunto.
Otras familias de roles para las que seguimos contratando: backend (Go, Java, Node.js, Python), frontend y full-stack (React, Next.js, Angular, TypeScript), mobile (React Native, Flutter, Swift y Kotlin nativos), DevOps y SRE, ingeniería de datos y líderes de producto o técnicos. Si tu stack encaja pero ninguna publicación coincide, mandá el CV con un párrafo sobre el tipo de trabajo que querés hacer.
Cómo trabajamos día a día
Prácticas de ingeniería que corren en todos los squads — no slogans en una pared.
El code review es la norma
Nada se mergea sin un segundo par de ojos. Dos reviewers en todo lo que toca una superficie pública. El CI tiene que estar en verde — sin merges forzados — y la descripción tiene que explicar el trade-off, no solo el diff. Quien entra hace su primer review el primer día, aunque sea chico.
Tests, observabilidad y runbooks
Los tests viven al lado del código que cubren. Cada squad es dueño de su parte de la observabilidad — logs estructurados, métricas RED y traces — y de los runbooks de las alertas principales. Si un sistema despierta a alguien, ese alguien está en el squad que lo escribió.
Pairing en los problemas difíciles
El pair programming no es un ritual diario, pero es la norma cuando el ticket es difícil de verdad, cuando alguien es nuevo en el código o cuando un senior acompaña a un semi senior en un rediseño. Le reservamos de 60 a 90 minutos, no cinco.
Retros que se cierran
Hasta tres acciones por retro, cada una con un responsable. La retro siguiente arranca con cuántas se cerraron. El teatro de retro — muchos post-its y cero seguimiento — es la falla que vigilamos, del lado del squad y del lado del cliente.
La documentación vive en el repo
ADRs, runbooks y design notes viven al lado del código, en Markdown. Confluence está bien para el cliente, pero el registro de las decisiones de ingeniería es el repo. Tu yo del futuro los lee más que el reviewer original.
No a la sobreingeniería
Los tech leads tienen veto explícito sobre la complejidad prematura. No arrancamos una migración a microservicios en el sprint cero, no armamos nuestra propia cola y no elegimos una herramienta para el CV. Si un senior quiere usar algo nuevo, el ADR explica por qué se descartó la opción más simple.
NOTA 2025–2026
Casi todos los repos de clientes en los que trabajamos hoy tienen al menos un asistente de IA en el flujo, en general Cursor, Claude Code o GitHub Copilot, más code review asistido por IA en los pull requests. La habilidad que evaluamos pasó del volumen al criterio con asistencia de IA — revisar diffs generados por IA, rechazarlos cuando el trade-off está mal y escribir el test que demuestra que el modelo se equivocó. Si usaste estas herramientas en serio el último año, contalo en tu nota; si las evitaste a propósito, también es una conversación válida para la primera llamada.
Un primer mes típico en Siblings
Basado en cómo fueron los onboardings senior de los últimos dos años. El tuyo va a variar, pero la forma es real.
SEMANA 1
Cuentas, runbooks, primer PR
Llega la notebook, se configuran cuentas y accesos, doble factor en todo. El tech lead te explica la arquitectura en media hora y te pasa los runbooks que el squad ya escribió. Para el miércoles o jueves abrís tu primer pull request — en general un ticket chico y real. Dos reviewers, CI en verde, mergeado antes del viernes.
Objetivo: probar que el circuito funciona de punta a punta, no entregar una feature.
SEMANA 2
Acompañar al cliente, tomar una parte
Te sumás a la daily del cliente, participás de la próxima sprint planning y tomás una parte real del trabajo, normalmente detrás de un feature flag para acotar el riesgo. Leés uno o dos ADRs que el equipo ya escribió y anotás preguntas sobre decisiones que todavía no están documentadas. De un senior esperamos la pregunta incómoda.
Objetivo: ser dueño/a de una parte, no solo observar.
SEMANA 3
Primera design note, reviews cruzados
Escribís tu primera design note: trade-offs explícitos, alternativas con nombre y por qué se descartó lo más simple. El tech lead la revisa, a veces la discute, y la mejor versión entra al repo como ADR. Empezás a revisar pull requests de otros — semi seniors y seniors — y alguno de ellos ya revisa los tuyos.
Objetivo: aportar a las decisiones de ingeniería, no solo al código.
SEMANA 4
Mostrar tu parte, cerrar tu primera acción de retro
En la demo del viernes mostrás lo que construiste detrás del flag, y lo activás para un grupo interno si las métricas acompañan. Tu nombre está en una de las tres acciones de la retro, y para la siguiente ya está cerrada. Empezás a saber quién decide qué del lado del cliente, y quién solo está en la llamada.
Objetivo: ser un senior del squad, no alguien nuevo al que hay que gestionar.
Sin piso, sin tres meses de shadowing, sin un "proyecto de ramp-up" que nunca sale. Los ingenieros a los que les gusta tirarse a la pileta dicen que esta es la parte de la empresa que no cambiarían.
Dónde contratamos
Somos remote-first en toda Latinoamérica. El equipo central de ingeniería trabaja desde nuestra oficina en Córdoba, Argentina, en Sipe Sipe 1479, donde a veces los ingenieros se juntan en persona. La mayoría de los proyectos son 100% remotos, con el squad repartido en varios países de la región.
La mayoría de los roles están limitados a ciertos países por la estructura legal o de cumplimiento del cliente — por ejemplo, el rol de Lead Infrastructure Engineer de arriba es para candidatos en México, y el de Senior AI Engineer para candidatos en Brasil. Otros, como GCP Security, están abiertos en quince países de Latinoamérica con buena conexión y una jornada que coincida con la zona horaria del cliente.
Como la mayoría de los clientes está en horario EST o de Reino Unido y Europa occidental, vas a trabajar en horario de negocio de Estados Unidos desde Latinoamérica. Desde Ciudad de México o Bogotá es un día normal. Desde Buenos Aires o Córdoba el día arranca un par de horas más tarde que un 9 a 18 local y termina un par de horas más tarde. Lo decimos claro en la entrevista porque no es para todos, y fingir que sí quema a cualquiera para el cuarto mes.
Trabajar en una empresa de outsourcing vs in-house vs como freelance
Para ingenieros senior de Latinoamérica que eligen entre las tres. Contratamos gente de los tres grupos y perdimos gente hacia los tres. Esta es la comparación honesta.
SIBLINGS (OUTSOURCING)
Un cliente a la vez, recorrido largo
- Un proyecto con un cliente por meses o años, según el rol
- Pago mensual como contractor, en USD
- Pares senior en el mismo squad y un tech lead
- Dejás el on-call cuando termina el proyecto
- Menos influencia directa en el roadmap del cliente que alguien interno
- Sin equity
Ideal si querés profundidad en un producto y un pago mensual estable en USD sin manejar tu propio pipeline comercial.
EMPLEO IN-HOUSE
Una empresa, horizonte largo
- Recorridos que se miden en años, no en proyectos
- Sueldo local, muchas veces en moneda local, a veces con equity
- Beneficios laborales del país
- Más influencia en contrataciones, roadmap y cultura
- Riesgo de un solo stack y un solo dominio
- Las reestructuraciones y la política interna te tocan a vos
Ideal si querés construir una empresa a largo plazo y aceptás el trade-off de sueldo local y reestructuraciones.
FREELANCE / MARKETPLACE
Muchos clientes, tu propio pipeline
- Varios proyectos más cortos, más autonomía sobre los horarios
- Facturación por hora en USD en Upwork, Toptal o contratos directos
- Vos manejás ventas, contratos, facturación e impuestos
- Sin code review de pares ni guardias compartidas
- Ingresos que varían de un trimestre a otro
- La carrera depende de qué trabajos aceptás
Ideal si querés máxima autonomía, te sentís cómodo/a llevando un negocio y no necesitás la mentoría de un squad senior.
Ninguna es mejor en todos los casos. Los seniors que más se quedan suelen ser los que eligieron la opción A sobre la B o la C por una razón clara. Los que nos toman por defecto porque no hay otra cosa abierta son también los que más rápido se van. Preferimos perderte por el trabajo in-house correcto antes que tenerte un año en el puesto de outsourcing equivocado.
Lo que podemos contar con honestidad
Una empresa que contrata en Latinoamérica para clientes de Estados Unidos tiene una oferta con una forma específica. Esta es esa forma.
Compensación en USD
La compensación se define en USD y se revisa periódicamente. La estructura exacta del contrato depende de tu país y de si el proyecto es por alcance o un puesto en un equipo dedicado — lo resolvemos con cada candidato en la etapa de oferta.
Visibilidad del proyecto
Muchos proyectos duran de uno a tres años y otros son engagements de duración fija de dos a cinco meses con posible extensión. Te decimos desde el principio de qué se trata el proyecto y cuál es el horizonte realista.
Entorno de trabajo en inglés
El idioma de trabajo diario es el inglés — PRs, design notes, dailies, retros y llamadas con el cliente. Entre compañeros de Latinoamérica el español fluye igual. Trabajar en inglés con ingenieros senior de Estados Unidos y Europa es una de las cosas que más hace crecer una carrera acá.
Variedad de stacks
Vas a trabajar con stacks modernos en lugar de pasar tres años en un solo framework: Go, Rust, Java con Spring, Node, Python, React, Next.js, Angular, React Native, Flutter, AWS, GCP y Azure. La mezcla exacta depende del cliente. La forma de nuestro trabajo se parece bastante a lo que reportan los seniors en la Encuesta de Developers de Stack Overflow — Go y Python crecen en backend, Java con Spring sigue en todos lados y TypeScript corre en las dos puntas de la aplicación en la mayoría de los squads de producto.
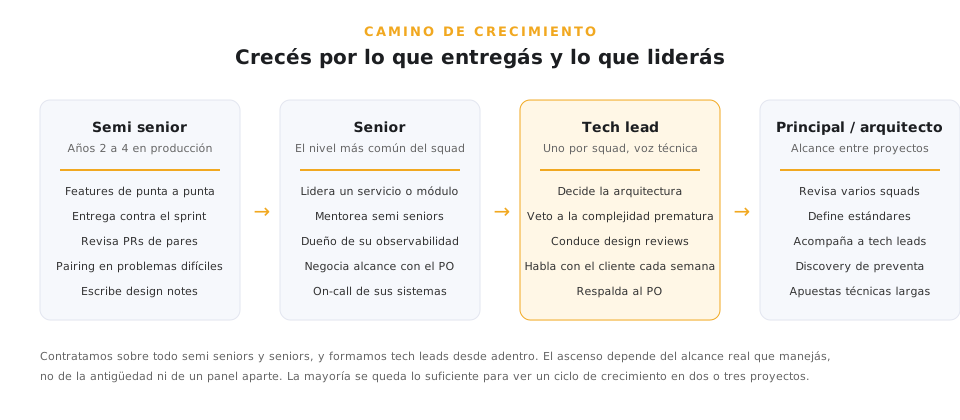
Crecimiento hasta tech lead
Contratamos sobre todo semi seniors y seniors, y formamos tech leads desde adentro. El ascenso depende del alcance que realmente manejás en proyectos reales, no de la antigüedad ni de un panel interno. El diagrama de crecimiento de arriba muestra cómo funciona en la práctica.
Horario flexible, con una ventana
Dentro de la ventana de overlap con el cliente, tu día es tuyo. No pedimos estar conectado a Slack todo el día, no hacemos llamadas obligatorias fuera de horario y no te vamos a llamar por sistemas que tu squad no construyó.
Lo que no prometemos
Somos claros con lo que no está incluido por defecto: stock options, un calendario fijo de vacaciones, cobertura de salud atada a la nómina de un país y comida gratis. Algunas cosas dependen de la estructura del contrato y del país y las resolvemos caso por caso; otras simplemente no son parte de cómo funciona una empresa que trabaja con contractors en Latinoamérica. Si son críticas para vos, hablemos antes de que cualquiera de las partes invierta una hora de entrevista.
Cómo se siente un engagement real desde adentro
Mini caso de estudio.
Un ejemplo útil es Bari, plataforma B2B que conecta mayoristas y retailers. Siblings armó un equipo con backend, frontend y gestión de proyecto. El stack incluyó .NET Core, React y GraphQL. No era un marketplace de juguete: había distribuidores, pedidos y operaciones que no podían pausar mientras el software evolucionaba.
Para un desarrollador, lo interesante son los tradeoffs. GraphQL redujo churn de endpoints con frontend en movimiento. El backend respetó reglas comerciales reales. El equipo lanzó en meses y siguió con mantenimiento y evolución. Ese tipo de engagement premia quien trabaja con ambigüedad, hace preguntas precisas y deja código entendible para el siguiente.
Más detalle en el caso de estudio Bari — ejemplo del trabajo detrás de muchos roles de esta página.
Qué aprende el ingeniero
- Cómo construir features alrededor de flujos de compra reales.
- Cómo coordinar decisiones frontend y backend sin specs perfectas.
- Cómo mantener un sistema post-launch cuando los usuarios muestran edge cases.
- Cómo un equipo chico comunica riesgo al cliente sin drama.
Qué diríamos a un candidato de entrada
Este proyecto no es para quien solo quiere tickets aislados. Pide ownership, paciencia con dominio y humildad para cambiar cuando usuarios o datos demuestran que una suposición estaba mal.
Qué puede salir mal en trabajo remoto con cliente — y cómo lo reducimos
Riesgos nombrados sin eufemismos.
Ownership difuso
Definimos quién revisa código, quién responde producto y quién escala bloqueos. La ambigüedad al inicio es normal; el silencio es el problema.
Sobrecarga de reuniones
Remoto no debería ser meetings todo el día. Favorecemos updates escritos concisos, standups útiles y documentación async cuando protege foco.
Seniority mal calibrado
Un rol junior-friendly y uno de ownership senior son trabajos distintos. Matcheamos según la ambigüedad que podés manejar.
Cambio de contexto del cliente
Las prioridades se mueven. Cuando pasa, hablamos impacto en alcance, salud del equipo y expectativas en lugar de fingir que nada cambió.
Mismatch de tecnología
No te vendemos como experto en un stack que apenas conocés. Aprender está bien; el proyecto tiene que tolerar esa curva.
Burnout disfrazado de urgencia
La producción tiene presión. Un equipo sano distingue un incidente real de mala planificación repetida cada semana.
Cómo aplicar
Una casilla, un proceso, ningún portal donde registrarse. Leemos todos los CVs que llegan.
Qué mandar
- Tu CV, idealmente en PDF, con el nombre del rol en el asunto
- Un link a GitHub, a un portfolio o a un par de repos representativos — incluso fragmentos privados que puedas explicar
- Una nota corta sobre por qué este rol y qué tipo de trabajo querés hacer
- Ubicación, zona horaria, nivel de inglés y fecha realista de inicio
- Certificaciones relevantes para la posición, si tenés
Qué pasa después
- Revisión del CV en tres a cinco días hábiles
- Si hay match, una entrevista técnica de 45 minutos sobre el rol, tu experiencia y el proyecto
- En algunos roles, un ejercicio corto para hacer en casa o live coding
- Una segunda charla con el tech lead o hiring manager si el squad ya está definido
- Oferta, estructura del contrato y fecha de inicio
Mandá tu CV a:
Si preferís leer primero sobre la empresa, mirá quiénes somos, nuestro equipo de liderazgo, a nuestro fundador Javier Uanini o los casos de estudio que muestran el tipo de trabajo que entregan los squads.
Si querés entender en qué tipo de proyectos estarías, las páginas de staff augmentation y de equipos dedicados describen lo que les ofrecemos a los clientes en esos modelos. También podés ver nuestra página de LinkedIn o nuestra organización de GitHub para conocer el lado público del equipo.
Preguntas Frecuentes
La mayoría de los clientes trabaja en horario del Este de Estados Unidos. Desde Ciudad de México, Bogotá y Lima el overlap con una jornada de 9 a 17 EST es de seis a ocho horas y coincide con un día local normal. Desde Buenos Aires, Córdoba, Montevideo y Santiago el día arranca y termina un par de horas más tarde. Algunos roles piden otra ventana, como horario del Pacífico o alguna reunión con Asia-Pacífico, y lo dicen en la publicación. Los detalles se confirman en la entrevista antes de firmar nada.
Depende del rol, y cada publicación lo indica. La mayoría de las posiciones abiertas hoy piden B2 o B2+, los roles de delivery con mucho contacto con el cliente, como Project Manager, piden C1, y un rol de seguridad cloud también pide español C1+. El idioma de trabajo para PRs, design notes y llamadas con el cliente es el inglés.
La mayoría de los proyectos funcionan con contratos de contractor, que es lo habitual cuando una empresa con base en Estados Unidos contrata en Latinoamérica. Algunos son puestos dedicados de largo plazo y otros son engagements de duración fija, por ejemplo de tres o cinco meses con posible extensión; cada publicación dice cuál es el caso. La documentación exacta depende de tu país y la resolvemos con cada candidato antes de la oferta.
La compensación se define en USD y se revisa periódicamente. En la mayoría de los países se paga mensualmente contra factura. Te ayudamos con la documentación del primer ciclo de facturación para que el proyecto arranque prolijo. No publicamos bandas salariales porque la seniority, el país y el tipo de engagement mueven el número; compartimos un rango concreto en la primera entrevista, cuando entendemos en qué puesto caería la oferta.
Apuntamos a una o dos semanas del CV a la oferta. La revisión del CV lleva de tres a cinco días hábiles. Los candidatos seleccionados hacen una o dos entrevistas técnicas, a veces con un ejercicio corto o live coding según el rol. Tratamos de no estirarlo, y te avisamos cuál es la ronda que define.
Sí. En 2025 y 2026, casi todos los repos de clientes tienen al menos un asistente de IA en el flujo, en general Cursor, Claude Code o GitHub Copilot, más code review asistido por IA en los pull requests. Esperamos que los seniors revisen con soltura diffs generados por IA, los rechacen cuando el trade-off está mal y escriban el test que demuestra que el modelo se equivocó. Lo que evaluamos pasó del volumen al criterio con asistencia de IA.
Backend en Go, Rust, Java con Spring, Node.js y Python. Trabajo de IA en Python con LLMs, RAG y frameworks de agentes como LangGraph, muchas veces sobre Vertex AI. Cloud, seguridad e infraestructura en GCP y AWS con Terraform, Kubernetes y GitHub Actions. Mobile en Swift y Kotlin nativos, React Native y Flutter, con Espresso, XCUITest y Appium para automatización. La mezcla cambia de proyecto en proyecto, pero esos son los stacks que más usan los squads.
NUESTROS ESTÁNDARES
Un proceso de carreras que gana la aplicación, no al revés.
Hablamos de compensación temprano, nombramos el contexto del proyecto antes de la charla técnica y decimos qué es incierto en lugar de fingir que todo engagement es igual. El tiempo del candidato debería comprar claridad, no pipelines vagos.
Matcheamos ingenieros a proyectos donde el cuello de botella coincide con su experiencia, con owner real del lado del cliente y reviewer senior nuestro. Los roles son remotos, la comunicación es honesta y el feedback después del proceso es accionable.